AI 语料数据知识产权登记案例:预训练语料的确权实践
大模型产业链里,算力可以租、算法可以开源,唯独训练数据的权属最难说清。预训练语料被爬取方与版权方各执一词、数据交易因权属不清而搁置、融资入表拿不出资产凭证——训练数据权属已经是 AI 产业链的核心争议。本文以一例真实的 AI 语料登记为样本,拆解预训练语料从加工到确权的实践路径。应权利人要求,本文对权利人信息做脱敏处理,仅保留数据集名称、登记号与获证时间等公开要素。
一、大模型时代,语料为什么必须确权
预训练语料的加工链条很长:采集、清洗、去重、质量过滤、标注、配比,每一环都投入大量人力与算力成本。加工后的语料集合,已经不是「网上能随便下载的文本」,而是凝聚了实质性加工投入的智力成果。但在登记确权出现之前,这份投入缺乏权属凭证支撑,直接带来三个问题:
① 交易难定价——权属说不清,语料在数据交易所挂牌、对模型厂授权时都缺乏可信背书;
② 维权无凭证——辛苦加工的语料被同行搬运,企业难以举证「这份数据集合是我的」;
③ 入表缺资产——数据资源要作为资产入表或质押融资,前提是权属清晰,语料恰恰是最说不清的那一类。
数据知识产权登记以「合法来源、实质性加工、明确应用场景」为要件,正好匹配语料的加工特征。它与软件著作权保护的对象并不相同,两者的区别可参考数据知识产权和软件著作权的区别一文。
二、案例:AI 基座大模型预训练垂直语料数据集登记
权利人背景:某数据服务企业(脱敏处理),面向垂直领域大模型的训练需求,围绕特定行业持续采集文本数据,经清洗、去重、结构化加工后形成大规模预训练垂直语料,供下游模型训练使用。
数据集梳理:皓瀚天泽在协助确权时,重点帮助权利人补齐三件事:语料来源的授权链条说明、清洗与去重等加工环节的规则记录、语料在模型训练中的具体应用场景描述。最终以「AI基座大模型预训练垂直语料数据集」为对象提交登记。
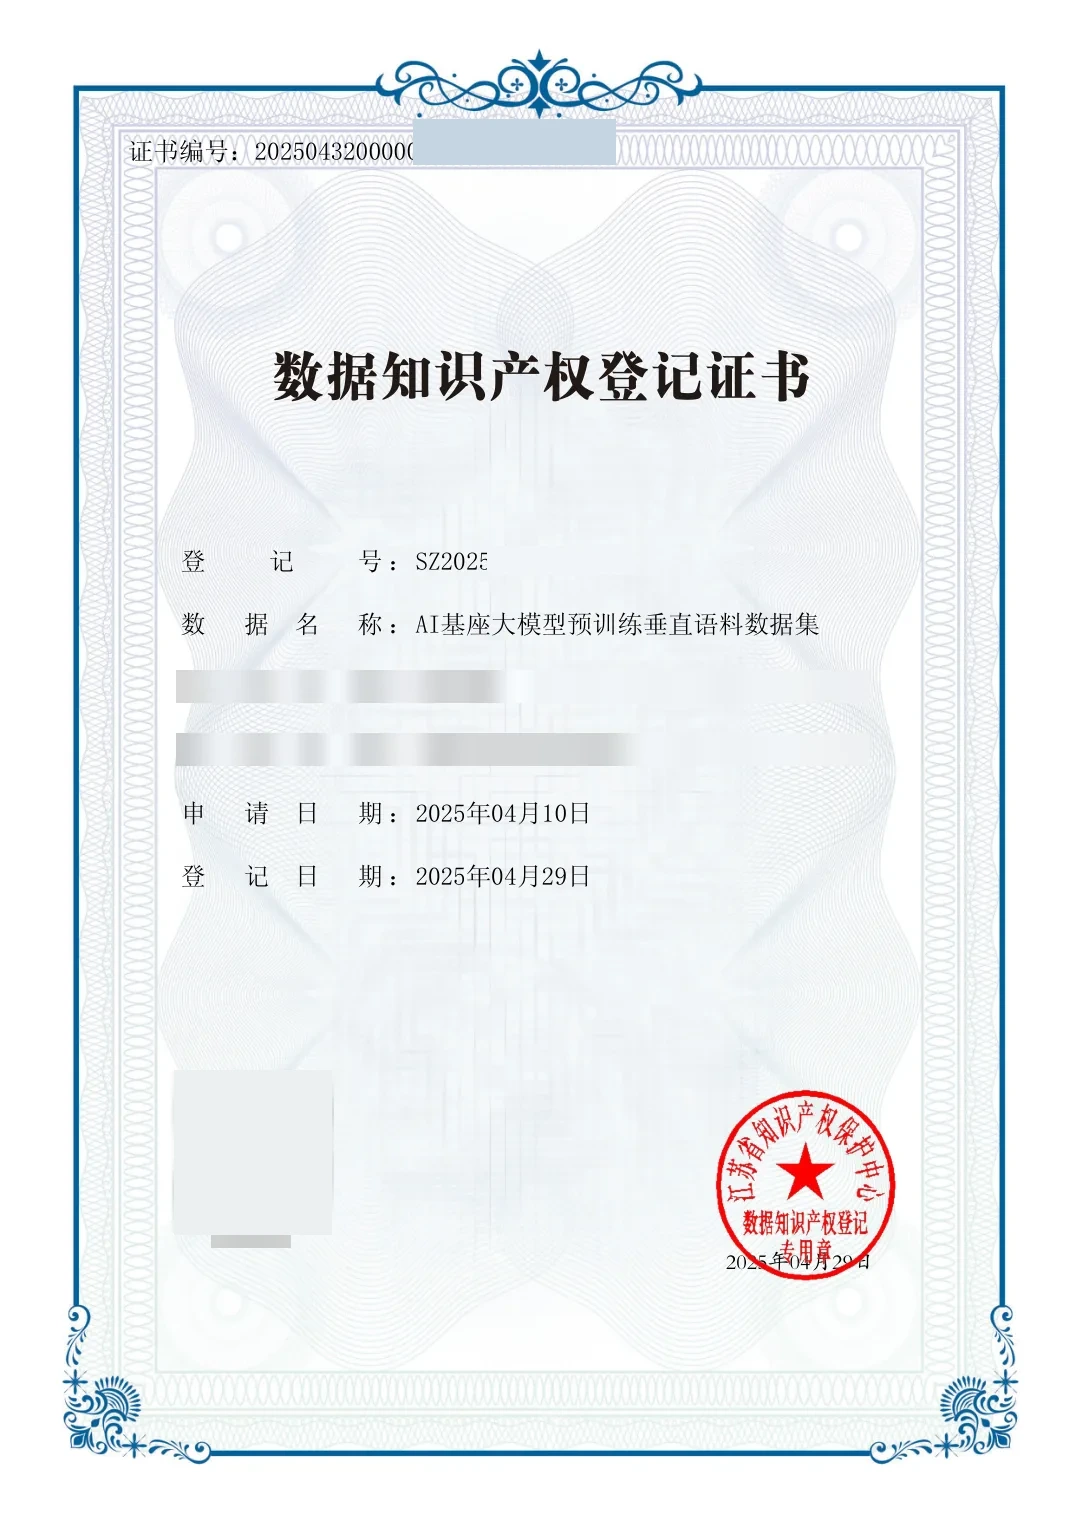
登记过程:登记在江苏省知识产权保护中心运营的数据知识产权登记平台办理,登记号为 SZ2025****2334.1,于 2025 年 4 月取得登记证书。证书落地后,该语料集合有了可公示查验的权属凭证,为后续对外授权与数据交易铺平了路。证书样式如下(权利人信息已脱敏):
三、AI 语料登记的三个特殊要点
与一般行业数据相比,AI 语料登记的合规门槛更高,实践中主要卡在三个环节:
① 来源合规性审查更严格——登记平台对语料来源的合法性审查严于一般行业数据:网络采集需说明采集方式与协议遵守情况,授权采购需提供合同或协议支撑,来源存在瑕疵的语料很难通过审查;
② 含个人信息需先匿名化——语料中如包含个人信息,须先完成匿名化或去标识化处理,并留存处理过程的记录,未处理的语料无法通过合规审查;
③ 加工与筛选过程要留痕——清洗规则、去重标准、质量过滤条件、语料配比方案等加工环节的记录,是证明「实质性加工」的关键材料,建议在加工阶段就同步归档。
四、AI 企业可登记的数据类型清单
结合本案例与本机构 126 份证书样本的统计(AI 语料与算法数据类 13 件),AI 企业可重点盘点以下五类数据:
| 数据类型 | 典型示例 | 应用场景 |
|---|---|---|
| 预训练语料类 | 垂直领域预训练语料、通用文本语料 | 训练资产确权、对外授权 |
| 语音数据类 | 多语种 ASR/TTS 语音数据集、语对语料 | 语音模型训练、数据交易 |
| 标注数据类 | 图文对标注数据、指令微调数据集 | 模型微调服务、数据产品化 |
| 评测数据类 | 模型评测基准数据集 | 评测服务、行业标准参与 |
| 多模态数据类 | 图文对数据集、场景图像数据集 | 多模态模型训练、授权输出 |
登记并非 AI 企业的专属动作——同一批样本中,农业培育数据同样完成了登记,可参考农业数据知识产权登记案例;制造业企业的打包登记策略见制造业数据知识产权登记案例。
五、三类语料来源的合规处理方式
语料登记的成败,八成取决于来源能不能说清。按来源分三类,处理方式差别很大:
| 来源类型 | 需要提供什么 | 主要风险点 |
|---|---|---|
| 自主采集 | 采集范围与频次说明、内部采集规范、目标站点协议遵守情况 | 未说明采集的合理边界,被认定超出必要范围 |
| 授权采购 | 采购合同、供方的权属承诺、是否允许再加工与转授权的条款 | 合同只授权「使用」不含「再加工」,用途越界 |
| 开源 / 公开语料 | 原始许可协议、许可类型是否允许商业使用与衍生 | 许可为 NC(非商用)或 ND(禁止衍生),无法登记 |
三类里最容易出问题的是授权采购。数据采购合同里若不写明「允许再加工并形成衍生数据集」,那么加工后的语料集合在权属上就站不住——你加工投入很大,但授权基础不覆盖这个用途。这种情况需要先补签条款,再谈登记。
开源语料的问题则更隐蔽:很多团队直接用了「网上能下载」的语料,没核对许可类型。CC-BY-NC、CC-BY-ND 这类许可禁止商业使用或禁止衍生,基于它加工的数据集不能用于商业登记。核对一次许可,比事后返工便宜得多。
六、常见疑问(FAQ)
Q:AI 训练语料可以登记数据知识产权吗?
A:可以。经过采集、清洗、去重、标注等加工形成的结构化语料数据集,来源合法、有明确应用场景的,可申请登记,本文案例即为预训练垂直语料的登记实践。
Q:爬取的数据能登记吗?
A:需视来源合规性而定。需说明采集方式、遵守目标网站协议、不涉及个人信息与侵权内容,并提供相应证明;来源存在瑕疵的语料难以通过合规审查,建议先做合规体检再申报。
Q:语料登记会公开数据内容吗?
A:不会全量公开。登记提交的是数据集合的存证摘要、加工说明与应用场景描述等材料,不是语料全文;具体披露范围以各登记平台规则为准。
Q:语料确权对 AI 企业有什么实际价值?
A:权属清晰的语料可用于数据交易所挂牌、对外授权、数据资产入表与质押融资,也是应对训练数据权属争议时的重要凭证。